Quando uma eleição está decidida?
Na noite da eleição, os resultados chegam aos poucos. Cada urna eletrônica é encerrada, imprime o boletim de urna e transmite os dados para a Justiça Eleitoral. Os totais nacionais vão sendo atualizados conforme esses lotes chegam. Em algum momento, muitas vezes bem antes de 100% das urnas apuradas, a imprensa passa a dizer que um candidato está matematicamente eleito.
O que exatamente quer dizer “matematicamente eleito”? E dá para escrever isso de forma precisa?
Acho útil olhar para esse problema pela ótica da amostragem.1 Os eleitores estão agrupados em seções eleitorais, e cada seção é apurada de uma vez só. Ou seja, é uma amostra de conglomerados: as seções já apuradas são os conglomerados observados por inteiro, as que faltam são a parte não observada da população, e o resultado final é um total populacional. É exatamente o cenário da inferência baseada em modelos (ou abordagem preditiva) para populações finitas. A única diferença é que, para a decisão determinística, o “modelo” é o mais fraco possível: ele só diz quais valores são possíveis.
Notação
Antes de fazer as contas, precisamos definir algumas coisas. Começando pelos conglomerados:
- \(U = \{1, \dots, N\}\) é o conjunto das \(N\) seções eleitorais.
- \(s \subset U\) é o conjunto das \(n\) seções já apuradas; chamaremos isso de amostra.
- \(r = U \setminus s\) é o conjunto das \(N - n\) seções ainda não apuradas: a parte não observada da população.
- \(M_i\) é o eleitorado da seção \(i\) — i.e., o tamanho do conglomerado. Ele é conhecido para todas as seções antes da eleição.
- \(M_0 = \sum_{i \in U} M_i\) é o eleitorado total.
Dentro da seção \(i\), os eleitores são indexados por \(j = 1, \dots, M_i\). Fixe um candidato \(k\) e defina, para o eleitor \(j\) da seção \(i\):
- \(y_{ij} = 1\) se ele vota em \(k\), e \(y_{ij} = 0\) caso contrário;
- \(z_{ij} = 1\) se ele dá um voto válido (em qualquer candidato), e \(z_{ij} = 0\) caso contrário — i.e., se vota em branco, anula ou não comparece.
Para qualquer variável \(v_{ij}\), denotamos o total da seção \(i\) por
\[v_i = \sum_{j = 1}^{M_i} v_{ij}.\]
Assim, \(y_i\) é o número de votos de \(k\) e \(z_i\) é o número de votos válidos na seção \(i\). Os totais populacional, da amostra e da parte não observada são
\[t_v = \sum_{i \in U} v_i,\]
\[t_{vs} = \sum_{i \in s} v_i,\]
\[t_{vr} = \sum_{i \in r} v_i,\]
de modo que, trivialmente,
\[t_v = t_{vs} + t_{vr}.\]
Essa identidade é o ponto central. A qualquer momento da noite, o primeiro termo é conhecido e o segundo é desconhecido. Tudo o que queremos dizer sobre o resultado final é uma afirmação sobre \(t_{vr}\).
Do mesmo jeito, o eleitorado das seções apuradas e não apuradas é
\[M_s = \sum_{i \in s} M_i,\]
\[M_r = \sum_{i \in r} M_i,\]
e ambos são conhecidos durante toda a noite.
Quem vence?
No Brasil, um candidato a presidente vence no primeiro turno se obtiver a maioria absoluta dos votos válidos, ou seja, estritamente mais da metade. O candidato \(k\) vence se
\[t_y > \frac{t_z}{2}.\]
É mais conveniente reescrever isso como uma margem. Para cada eleitor, defina o escore
\[a_{ij} = 2 y_{ij} - z_{ij}.\]
Ele só pode assumir três valores: \(a_{ij} = +1\) se o eleitor vota em \(k\), \(a_{ij} = -1\) se ele vota validamente em outro candidato, e \(a_{ij} = 0\) se ele vota em branco, anula ou não comparece. O total da seção,
\[d_i = \sum_{j = 1}^{M_i} a_{ij} = 2 y_i - z_i,\]
é a margem de \(k\) na seção \(i\): os votos de \(k\) menos os votos válidos de todos os demais. O candidato \(k\) vence se, e somente se,
\[t_d > 0.\]
Separando o total populacional em termos de amostra e parte não observada, temos
\[t_d = t_{ds} + t_{dr}.\]
O primeiro termo, a margem entre os votos já apurados, está na tela. O segundo é o que ainda falta ser apurado.
O pior caso numa seção
Este é o único fato de que precisamos.
Lema. Em qualquer seção \(i\), a margem satisfaz \(-M_i \le d_i \le M_i\).
Demonstração (clique para expandir)
Cada escore satisfaz \(|a_{ij}| \le 1\). Logo,
\[|d_i| \le \sum_{j = 1}^{M_i} |a_{ij}| \le M_i.\]
\(\blacksquare\)
Em palavras: cada eleitor mexe na margem em no máximo um voto. O pior que pode acontecer ao candidato \(k\) numa seção é todos os eleitores comparecerem e votarem (validamente) em outro candidato.
Quando o vencedor é certo?
Proposição 1. O candidato \(k\) vence com certeza, aconteça o que acontecer nas seções não apuradas, se, e somente se,
\[t_{ds} > M_r.\]
Ou seja, a margem já apurada precisa superar o número de eleitores das seções que ainda faltam.
Demonstração (clique para expandir)
(Se.) Some o lema sobre as seções não apuradas:
\[t_{dr} \ge -M_r.\]
Então
\[t_d = t_{ds} + t_{dr} \ge t_{ds} - M_r > 0.\]
(Somente se.) Suponha que \(t_{ds} \le M_r\). Considere o resultado em que todos os eleitores das seções não apuradas comparecem e votam validamente em outro candidato, isto é, \(a_{ij} = -1\) para todo \(i \in r\). Esse resultado é possível e, nele, \(t_{dr} = -M_r\). Logo,
\[t_d = t_{ds} - M_r \le 0,\]
e \(k\) não vence. \(\blacksquare\)
A parte do “somente se” é importante. Ela diz que a regra é exata: nenhuma outra regra determinística consegue decidir a eleição mais cedo.
Quem fica à frente de quem?
O mesmo argumento resolve qualquer comparação entre dois candidatos. É isso que importa no primeiro turno, quando a pergunta muitas vezes é quem vai para o segundo turno.
Para comparar \(k\) com outro candidato \(k'\), basta trocar o escore. Defina
\[b_{ij} = \begin{cases} +1, & \text{se o eleitor vota em } k, \\ -1, & \text{se o eleitor vota em } k', \\ 0, & \text{caso contrário,} \end{cases}\]
e seja \(c_i = \sum_{j=1}^{M_i} b_{ij}\) a vantagem de \(k\) sobre \(k'\) na seção \(i\).
Proposição 2. O candidato \(k\) termina estritamente à frente do candidato \(k'\) com certeza se, e somente se,
\[t_{cs} > M_r.\]
Demonstração (clique para expandir)
Como \(|b_{ij}| \le 1\), o lema vale com \(c_i\) no lugar de \(d_i\): \(-M_i \le c_i \le M_i\). Repita o argumento da Proposição 1. O pior caso, atingido quando todos os eleitores restantes votam em \(k'\), mostra que a condição também é necessária. \(\blacksquare\)
Uma regra prática baseada nos percentuais observados e fração apurada
Na TV, é difícil trabalhar com os totais: é bem mais fácil considerar os percentuais. Então, faz mais sentido reescrever a Proposição 1 nesses termos. Defina:
- \(\hat p_k = t_{ys} / t_{zs}\), o percentual do candidato \(k\) entre os votos válidos já apurados;
- \(f = M_s / M_0\), a fração do eleitorado nas seções já apuradas;
- \(\hat v = t_{zs} / M_s\), os votos válidos por eleitor nas seções apuradas, que combina comparecimento e votos válidos.
A margem apurada é
\[t_{ds} = t_{zs} \times (2\hat p_k - 1) = f \times M_0 \times \hat v \times (2\hat p_k - 1),\]
e o eleitorado não apurado é
\[M_r = (1 - f) M_0.\]
Substituindo na Proposição 1 e dividindo por \(M_0\), chegamos ao seguinte:
Regra prática. O candidato \(k\) está matematicamente eleito assim que
\[\hat p_k > \frac{1}{2} + \frac{1 - f}{2 f \hat v}.\]
Para a comparação entre dois candidatos, sendo \(\hat p_{k'}\) o percentual apurado de \(k'\), a condição análoga é
\[\hat p_k - \hat p_{k'} > \frac{1 - f}{f \hat v}.\]
Este limiar cai rapidamente quando \(f\) se aproxima de 1. Com \(\hat v = 0{,}75\), algo como 80% de comparecimento e 94% de votos válidos:
| Fração do eleitorado apurada, \(f\) | 0,80 | 0,90 | 0,95 | 0,99 |
|---|---|---|---|---|
| Percentual necessário para a certeza, \(\hat p_k\) | 66,7% | 57,4% | 53,5% | 50,7% |
Assim, um candidato com 52% dos votos válidos apurados só fica matematicamente eleito depois que cerca de 97% do eleitorado foi apurado. Uma vitória folgada é decidida muito antes.
A figura abaixo mostra o limiar como função de \(f\) para alguns valores de \(\hat v\). Em outras palavras, o eixo horizontal é a fração do eleitorado já apurada, \(f\), e o eixo vertical é o percentual dos votos válidos apurados de que o candidato \(k\) precisa para estar matematicamente eleito. Cada curva corresponde a um valor de \(\hat v\).
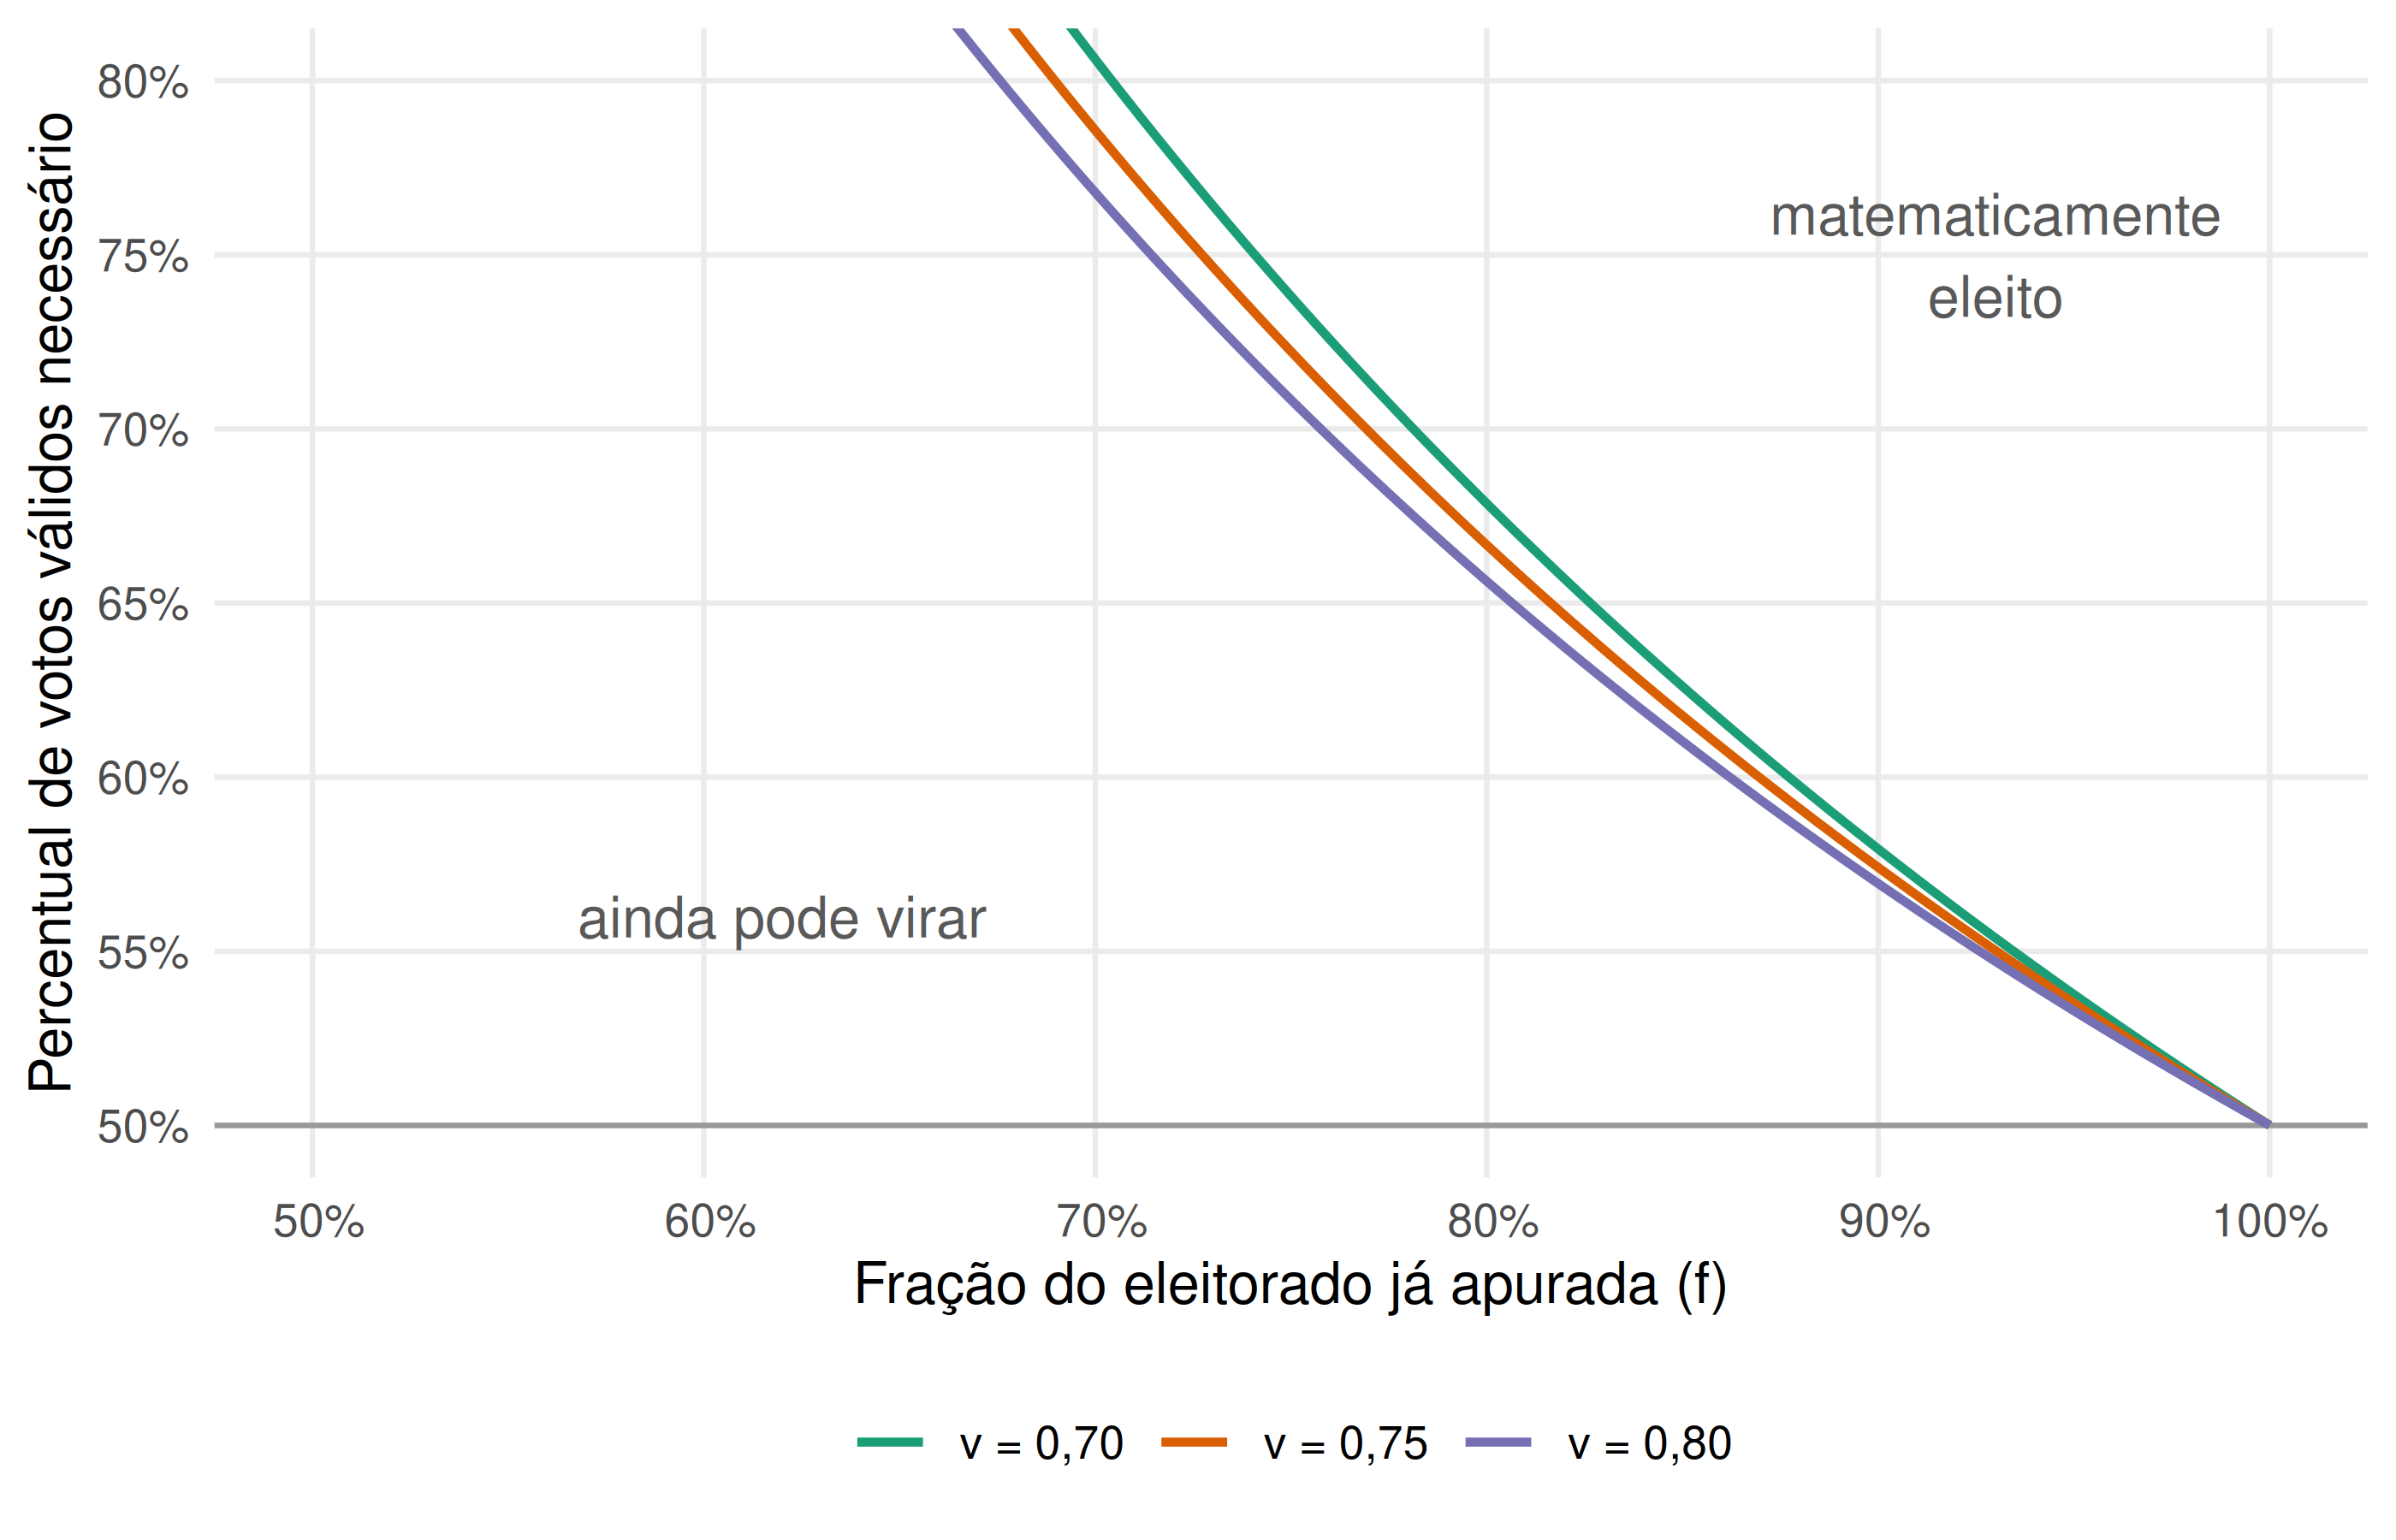
Figure 1: Percentual de votos válidos necessário para estar matematicamente eleito, em função da fração do eleitorado apurada.
Para usar a figura, basta localizar o momento da apuração e o percentual atual do candidato. Se o ponto estiver acima da curva, o resultado está decidido: nem o pior cenário nas seções restantes muda o vencedor. Se estiver abaixo, a eleição ainda pode virar. Isso não quer dizer que o candidato está perdendo, apenas que a vantagem dele ainda não é grande o bastante para resistir ao pior caso. Por exemplo, com \(\hat v = 0{,}75\) e 80% do eleitorado apurado, o candidato precisa de cerca de 67% dos votos válidos; com 90%, de cerca de 57%; com 95%, de cerca de 53,5%.
O formato das curvas conta a história da noite da eleição. No começo da apuração, o limiar é tão alto que só uma vitória esmagadora pode ser anunciada. Ele só se aproxima de 50% no fim, porque o termo \((1 - f)/(2f\hat v)\) é proporcional ao eleitorado que ainda falta. Por isso, eleições apertadas só são decididas com quase todas as urnas apuradas.
Já o valor de \(\hat v\) quase não importa: com 90% do eleitorado apurado, o limiar vai de cerca de 57,9% com \(\hat v = 0{,}70\) a cerca de 56,9% com \(\hat v = 0{,}80\). Isso acontece porque \(\hat v\) só muda a escala do termo que já está encolhendo com \(f\), e porque, na prática, \(\hat v\) varia pouco de uma eleição para outra. Quem manda é a fração apurada.
E se só conhecermos a fração de seções apuradas?
Há um problema prático: o TSE divulga o percentual de seções totalizadas, e não a fração \(f\) do eleitorado. Na linguagem de amostragem por conglomerados, o TSE mostra a fração de conglomerados apurados, enquanto a regra precisa da fração de elementos. Como as seções têm tamanhos diferentes, as duas frações não coincidem.
Felizmente, dá para contornar isso sendo um pouco restritivo. Defina:
- \(g = n / N\), a fração de seções apuradas;
- \(M_{\max} = \max_{i \in U} M_i\), o eleitorado da maior seção, conhecido antes da eleição.
Proposição 3. Se
\[t_{ds} > (N - n) \times M_{\max},\]
então o candidato \(k\) vence com certeza.
Demonstração (clique para expandir)
Como cada uma das \(N - n\) seções não apuradas tem no máximo \(M_{\max}\) eleitores,
\[M_r = \sum_{i \in r} M_i \le (N - n) \times M_{\max}.\]
Logo, a hipótese implica \(t_{ds} > M_r\), e o resultado segue da Proposição 1. \(\blacksquare\)
Usando \(t_{ds} = t_{zs} \times (2 \hat p_k - 1)\), a regra prática fica
\[\hat p_k > \frac{1}{2} + \frac{(1 - g) \times N \times M_{\max}}{2 \times t_{zs}}.\]
Tudo aqui está disponível na noite da eleição: \(g\) e \(t_{zs}\) (o total de votos válidos apurados) aparecem na tela, e \(N\) e \(M_{\max}\) são conhecidos de antemão.
Diferente da Proposição 1, essa condição é só suficiente: ela supõe que todas as seções restantes têm o tamanho da maior seção. O preço é decidir um pouco mais tarde.
Uma regra de risco controlado baseada na desigualdade de Cantelli
As regras anteriores só anunciam o resultado quando ele é certo. Isso tem um custo: elas tratam cada eleitor que falta como se fosse votar contra \(k\), o que na prática não acontece. Se aceitarmos um risco (pequeno) \(\alpha\) de errar, podemos anunciar bem antes. A questão é como fazer isso supondo o mínimo possível.
Na abordagem baseada em modelos, a incerteza está nos valores das seções não apuradas. Então podemos tratar a margem que falta apurar, \(t_{dr}\), como uma variável aleatória, e definir:
- \(\mu_r\): a média de \(t_{dr}\), ou o quanto esperamos que as seções restantes acrescentem à margem de \(k\);
- \(\sigma_r\): o desvio-padrão de \(t_{dr}\), ou o quanto isso pode variar em torno da média.
E só. Não supomos normalidade, nem nenhuma outra forma para a distribuição, nem independência entre seções: choques regionais e correlação entre seções vizinhas entram em \(\sigma_r\), sem mais hipóteses.
Com isso, podemos usar a desigualdade de Cantelli para derivar a “regra de Cantelli”:
Proposição 4 (Cantelli). Se \(t_{ds} + \mu_r > 0\), então
\[\Pr (\text{virada}) = \Pr (t_{dr} \le -t_{ds}) \le \frac{\sigma_r^2}{\sigma_r^2 + (t_{ds} + \mu_r)^2}.\]
Demonstração (clique para expandir)
Sejam \(x = t_{ds} + \mu_r > 0\) e \(W = \mu_r - t_{dr}\), de modo que \(E(W) = 0\), \(\operatorname{Var}(W) = \sigma_r^2\) e a virada é o evento \(W \ge x\). Para qualquer \(u \ge 0\), como \(x + u > 0\), a desigualdade de Markov aplicada a \((W + u)^2\) dá
\[\Pr (W \ge x) \le \Pr\{(W + u)^2 \ge (x + u)^2\} \le \frac{E\{(W + u)^2\}}{(x + u)^2} = \frac{\sigma_r^2 + u^2}{(x + u)^2}.\]
O lado direito é mínimo em \(u = \sigma_r^2 / x\), e nesse ponto vale \(\sigma_r^2 / (\sigma_r^2 + x^2)\). \(\blacksquare\)
Para garantir que o risco de virada seja no máximo \(\alpha\), basta exigir que esse limite seja no máximo \(\alpha\), o que dá a regra:
\[\text{anuncie } k \text{ quando } t_{ds} + \mu_r \ge z_\alpha \times \sigma_r, \quad \text{com } z_\alpha = \sqrt{\frac{1 - \alpha}{\alpha}}.\]
O fator \(z_\alpha\) faz o papel do quantil da normal, mas é bem maior, porque a garantia vale para qualquer distribuição:
| Risco \(\alpha\) | 10% | 5% | 1% | 0,1% |
|---|---|---|---|---|
| Cantelli, \(z_\alpha\) | 3,00 | 4,36 | 9,95 | 31,6 |
| Normal | 1,28 | 1,64 | 2,33 | 3,09 |
Uma forma natural de estabelecer valores para \(\mu_r\) e \(\sigma_r\) é escrever estas quantidades por eleitor restante:
\[\mu_r = \lambda \times M_r,\]
\[\sigma_r = \tau \times M_r.\]
Aqui, \(\lambda\) é a margem média por eleitor que esperamos nas seções restantes, e \(\tau\) é o desvio-padrão dessa margem. Com isso, a regra fica
\[t_{ds} > (z_\alpha \tau - \lambda) \times M_r,\]
que é a Proposição 1 com o eleitorado restante multiplicado por \(z_\alpha \tau - \lambda\).2 Em termos de percentuais, como na regra prática,
\[\hat p_k > \frac{1}{2} + (z_\alpha \tau - \lambda) \times \frac{1 - f}{2 f \hat v}.\]
A garantia continua valendo se \(\mu_r\) for menor que a média verdadeira e \(\sigma_r\) for maior que o desvio-padrão verdadeiro. Ou seja, ser conservador é subestimar \(\lambda\) e superestimar \(\tau\).
Talvez o melhor jeito de escolher \(\lambda\) e \(\tau\) seja olhar para eleições anteriores: em cada momento da apuração, quanto a margem por eleitor das seções restantes se desviou da margem por eleitor das seções já apuradas? A média desses desvios sugere \(\lambda\), e a sua dispersão, incluindo o pior caso observado, sugere \(\tau\).
Na prática, a regra de Cantelli pode ser utilizada seguindo estes passos:
- Escolha o risco \(\alpha\) aceitável.
- Escolha \(\mu_r\) e \(\sigma_r\) para as seções que ainda faltam (por exemplo, via \(\lambda\) e \(\tau\)).
- A cada atualização, verifique se \(t_{ds} + \mu_r \ge z_\alpha \times \sigma_r\).
- Verifique também a Proposição 1. Ela não depende de nenhuma hipótese, e às vezes decide antes; anuncie quando qualquer uma das duas for satisfeita.
Uma noite de apuração simulada
Para ver as regras em ação, simulei uma eleição com 20.000 seções divididas em cinco regiões. O candidato \(k\) é mais forte nas regiões que chegam por último, como costuma acontecer quando os primeiros boletins vêm das capitais. O resultado final é 52,6% dos votos válidos para \(k\).
Para a regra de Cantelli, usei \(\alpha = 0{,}01\), \(\lambda = 0\) e \(\tau = 0{,}03\). Esses valores são ilustrativos, não calibrados. Com eles, o eleitorado restante é multiplicado por \(0{,}3\).
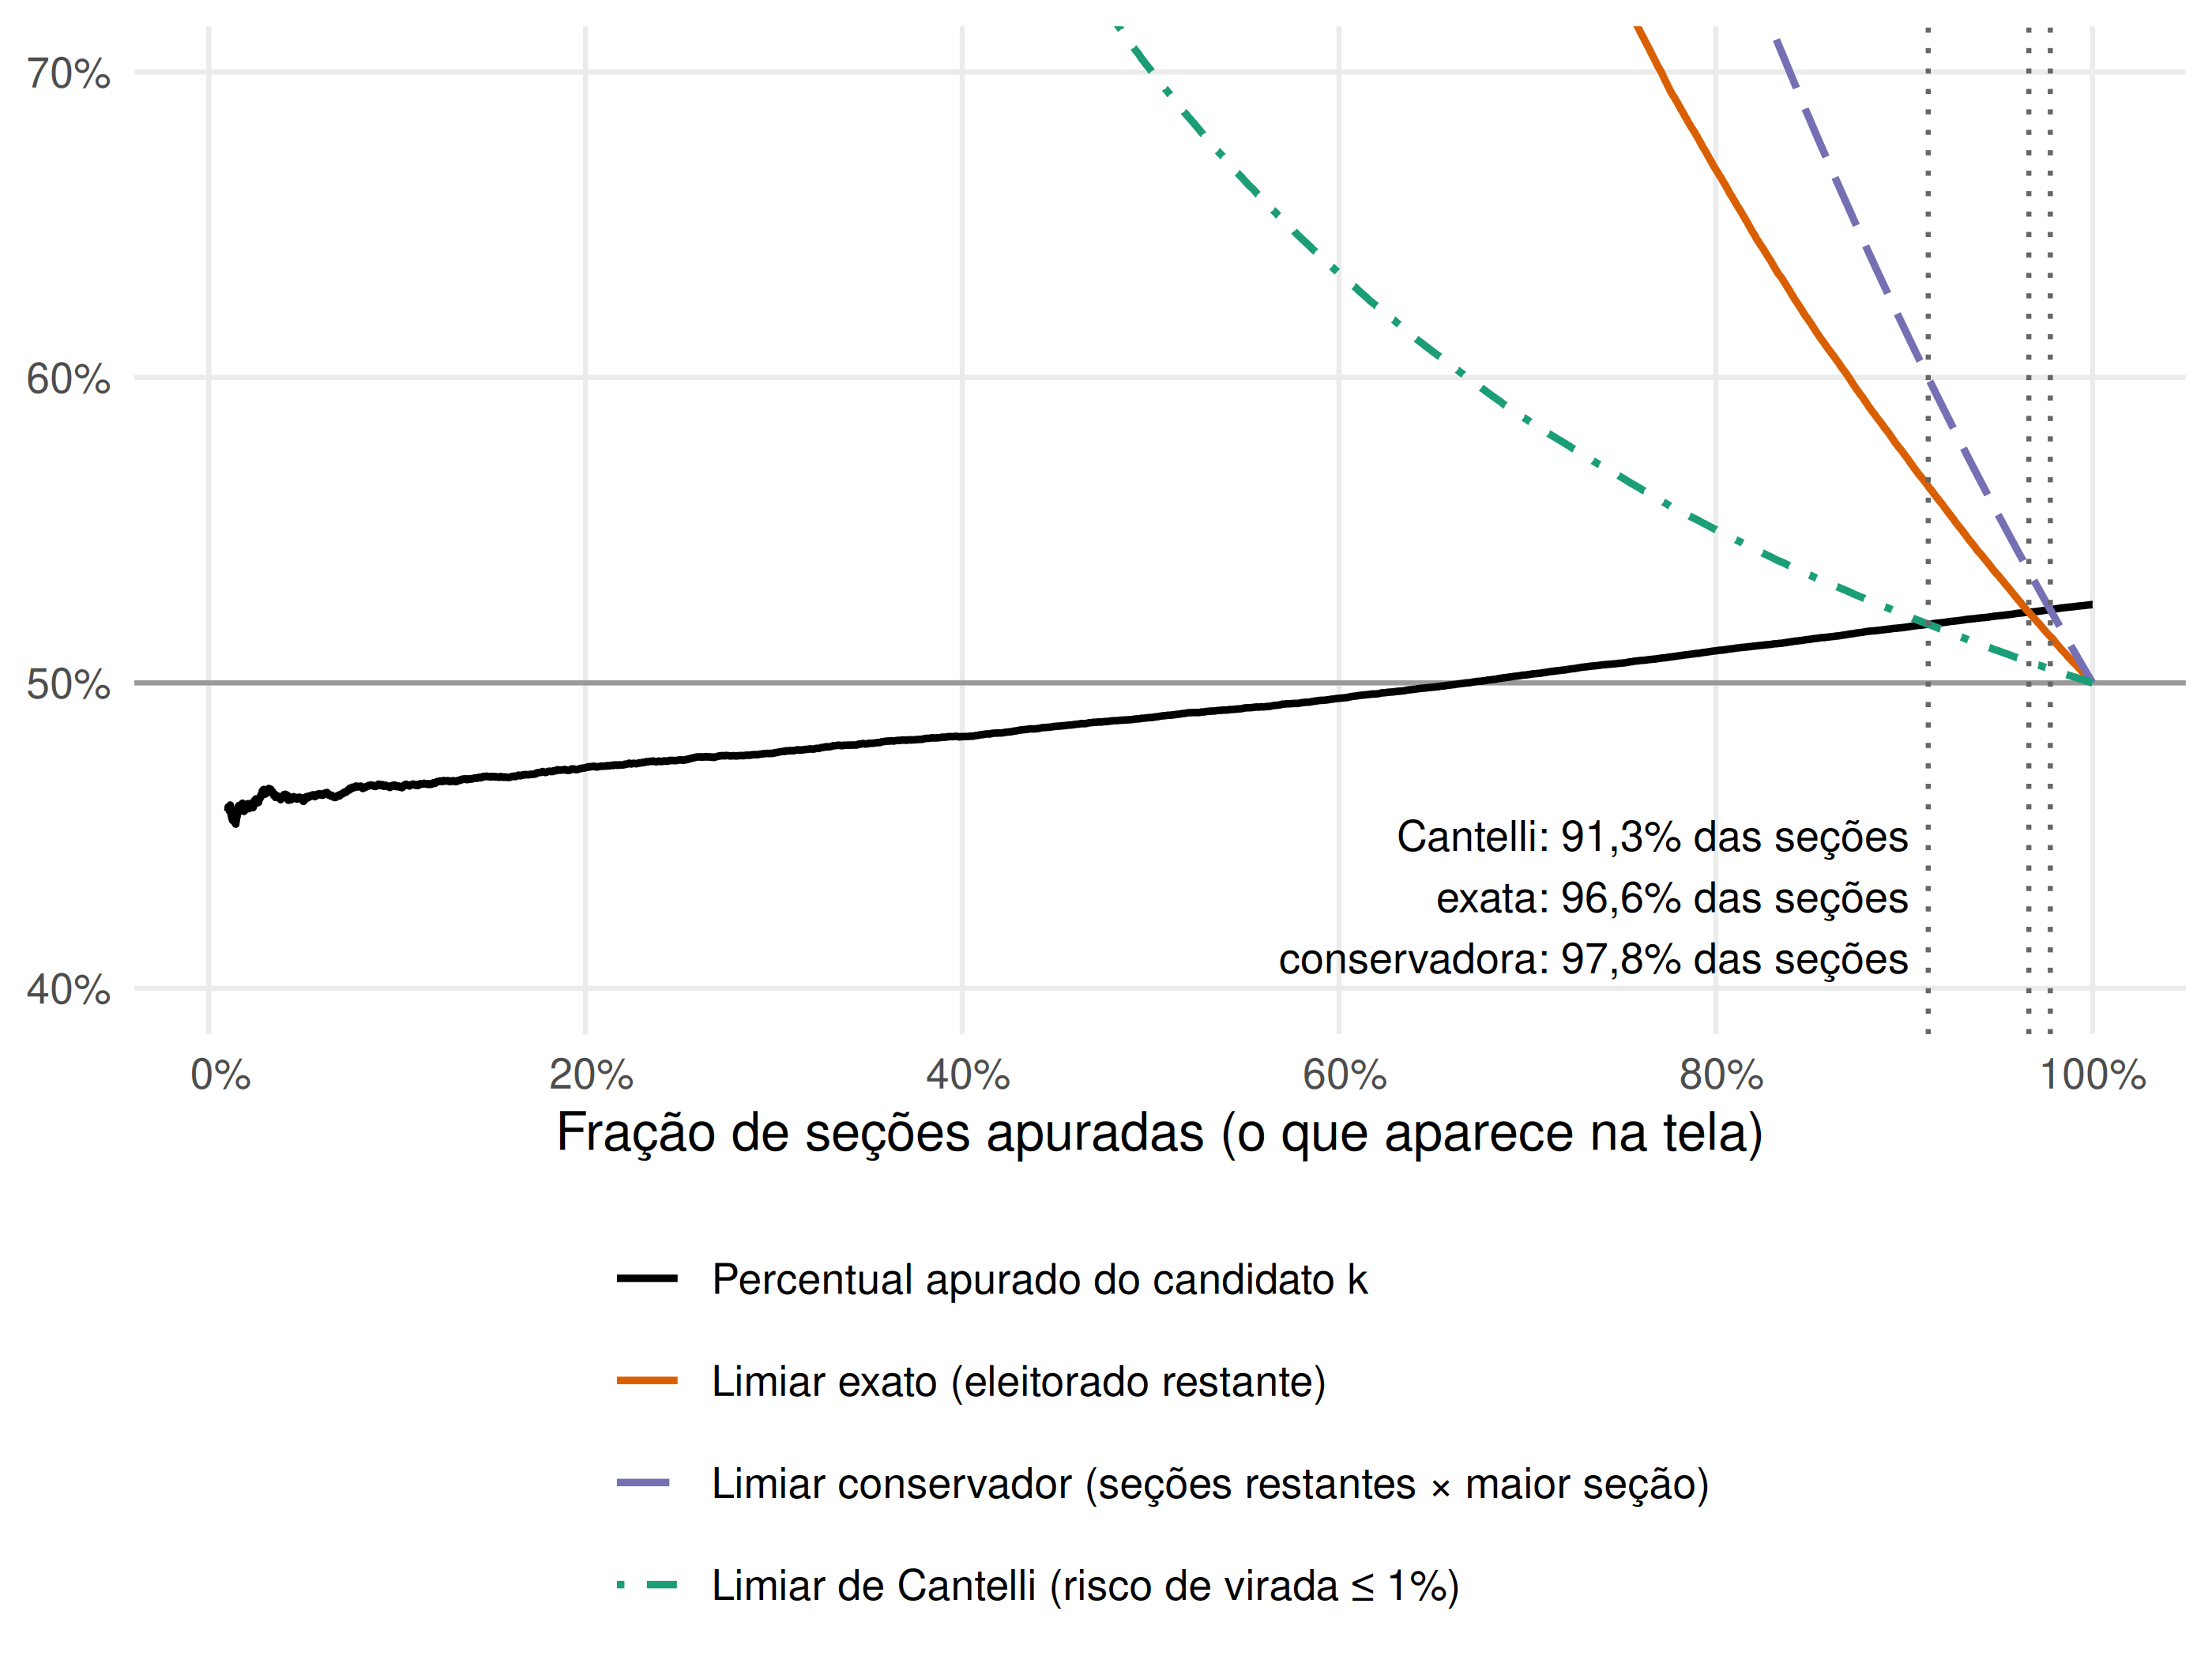
Figure 2: Percentual apurado do candidato k ao longo da noite, com os limiares exato, conservador e de Cantelli.
O candidato \(k\) começa a noite perdendo e só passa dos 50% com 66,7% das seções apuradas. A virada é real, mas ainda não garante nada: o limiar exato só é cruzado com 96,6% das seções apuradas, e o conservador com 97,8%. Aceitando um risco de virada de no máximo 1%, Cantelli permite anunciar o resultado já com 91,3% das seções apuradas, desde que as escolhas de \(\lambda\) e \(\tau\) sejam conservadoras.
Outra forma de ver a mesma coisa é pelo “intervalo” de valores possíveis para a margem final, \([t_{ds} - M_r,\ t_{ds} + M_r]\). A eleição está decidida quando o intervalo inteiro fica acima de zero.
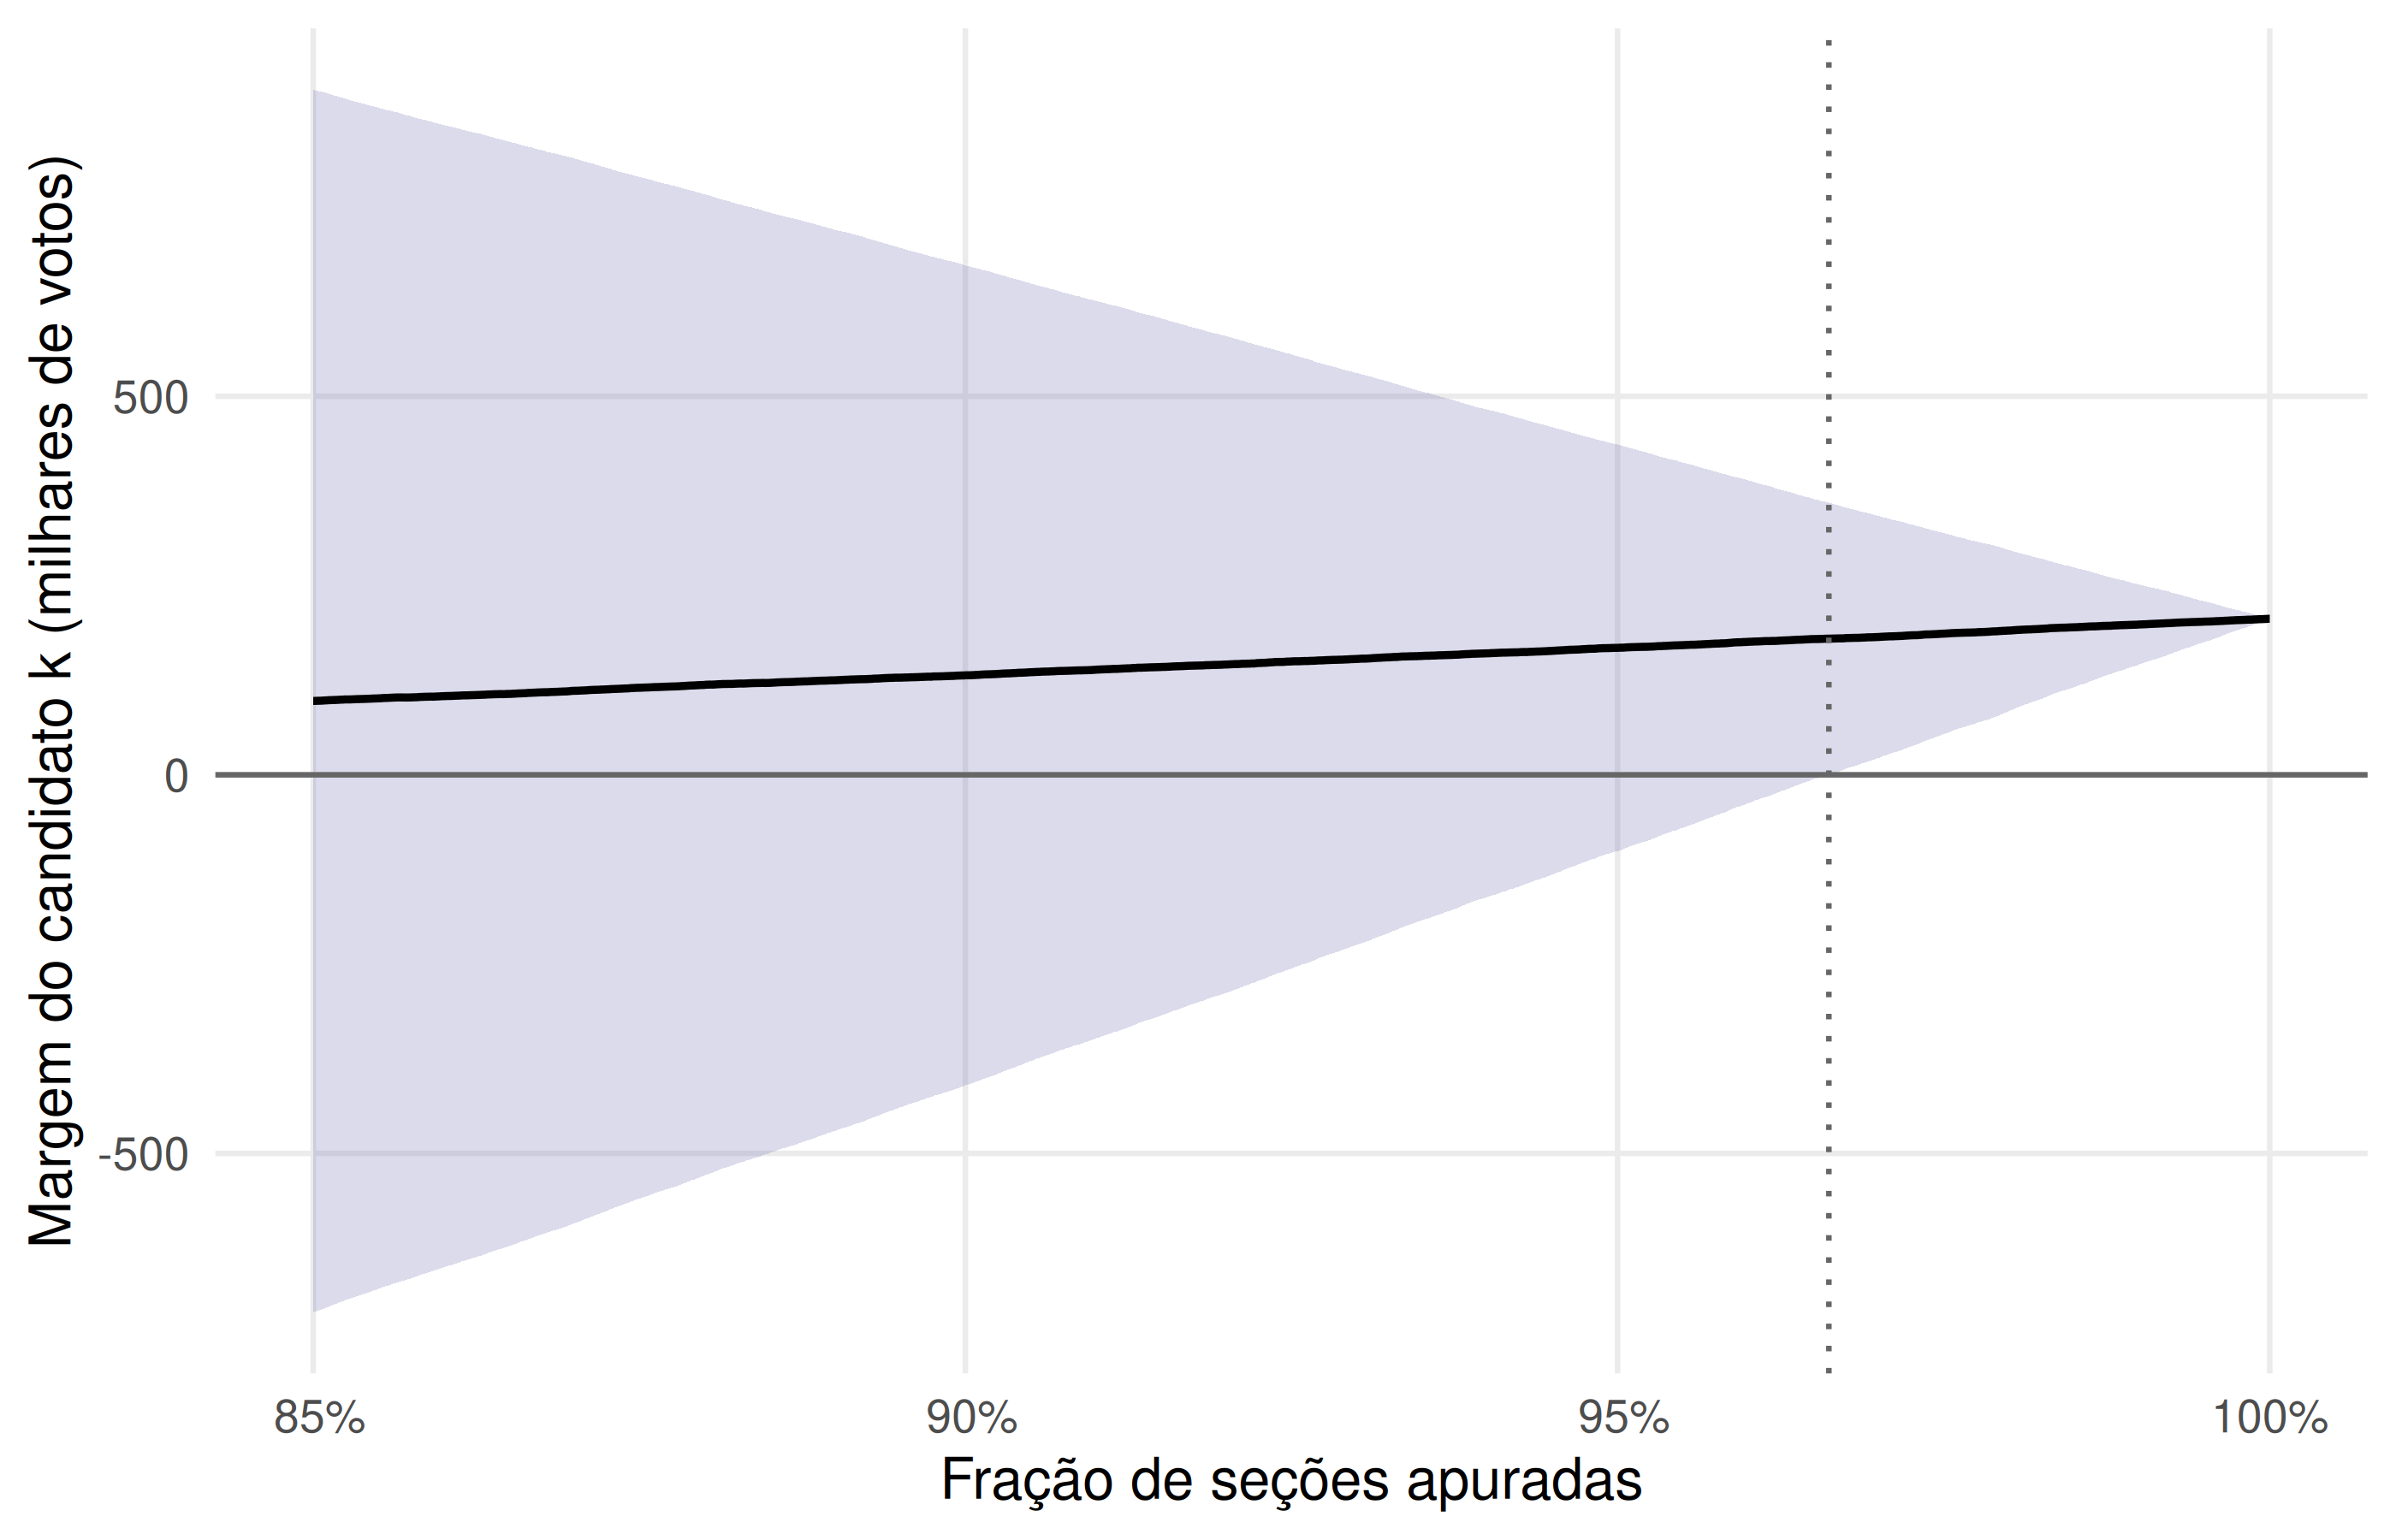
Figure 3: Intervalo de valores possíveis para a margem final do candidato k no fim da apuração.
Duas observações:
- Pondere pelo eleitorado, não pelo número de urnas. O “percentual de seções apuradas” mostrado na tela conta conglomerados, mas os conglomerados têm tamanhos diferentes. A regra exata precisa de \(f\) em termos de eleitores; com \(g\), use a Proposição 3.
- O cadastro precisa estar completo. A demonstração usa o fato de que todo eleitor pertence a alguma seção de \(U\) com eleitorado \(M_i\) conhecido. Votos que não estão ligados ao eleitorado de uma seção comum, como os votos no exterior ou o voto em trânsito, precisam estar em \(U\) como conglomerados próprios. Caso contrário, o pior caso fica subestimado.
Por que o TSE pode anunciar antes de 100%
Nada na Proposição 1 exige que \(r\) seja vazio. Ela só exige que a margem apurada supere o que as seções restantes poderiam, no máximo, desfazer. No fim da noite, as seções não apuradas são uma pequena cauda de áreas remotas, seções no exterior e eventuais urnas que precisam de apuração manual. O eleitorado total dessas seções, \(M_r\), é pequeno, e a condição é satisfeita. A apuração continua até o fim. Ela só não pode mais mudar o resultado.
Dá para prever quando a eleição vai ser decidida?
As proposições acima respondem à pergunta “a eleição já está decidida?”. Elas não dizem quando isso vai acontecer: o momento exato da decisão só é conhecido quando chegamos nele.
Ainda assim, dá para dizer alguma coisa. Suponha que a eleição ainda não está decidida e defina:
- \(G = M_r - t_{ds} > 0\), a distância que ainda falta para a condição da Proposição 1;
- \(m\), o eleitorado das seções que serão apuradas daqui para frente.
Cada eleitor apurado reduz \(M_r\) em um e muda \(t_{ds}\) pelo seu escore \(a_{ij}\). Isso dá duas respostas, uma sem modelo e outra com.
Proposição 5. A eleição não pode ser decidida a favor de \(k\) antes de serem apurados mais de \(G/2\) eleitores, isto é, antes de
\[m > \frac{G}{2}.\]
Esse limite é atingido quando todos os eleitores das próximas seções comparecem e votam em \(k\).
Demonstração (clique para expandir)
Depois de apuradas seções com \(m\) eleitores, a margem apurada é no máximo \(t_{ds} + m\), já que cada \(a_{ij} \le 1\), e o eleitorado restante é exatamente \(M_r - m\). Pela Proposição 1, a eleição só está decidida se
\[t_{ds} + m > M_r - m,\]
o que exige \(m > G / 2\). Se todos os \(m\) eleitores tiverem \(a_{ij} = +1\), a margem apurada é exatamente \(t_{ds} + m\), e a condição vale assim que \(m > G/2\). \(\blacksquare\)
Não existe um limite no sentido contrário: se as seções restantes favorecerem o adversário, a eleição pode ficar indefinida até a última seção.
A segunda resposta precisa de uma hipótese sobre o que ainda falta. Se as seções restantes se parecerem com as já apuradas, cada eleitor apurado acrescenta, em média, \(\hat v (2 \hat p_k - 1)\) à margem. A distância \(G\) então cai \(1 + \hat v (2 \hat p_k - 1)\) por eleitor apurado, e a decisão viria depois de
\[m^* = \frac{G}{1 + \hat v (2 \hat p_k - 1)}\]
eleitores. Se \(m^* > M_r\), essa projeção diz que a eleição não será decidida a favor de \(k\). Quando o percentual de \(k\) é o mesmo do começo ao fim da apuração, a decisão acontece na fração do eleitorado
\[f^* = \frac{1}{1 + \hat v (2 \hat p_k - 1)},\]
que é de onde veio o “cerca de 97%” para um candidato com 52%.
O problema é que essa projeção é tão boa quanto a hipótese de que o resto se parece com o que já foi apurado. Na noite simulada, ela erra bastante:
| Seções apuradas | Eleitorado apurado | Percentual de \(k\) | Decisão mais cedo possível (Prop. 5) | Decisão projetada |
|---|---|---|---|---|
| 30% | 29,9% | 47,7% | 65,4% | não decide |
| 50% | 50,0% | 48,9% | 75,4% | não decide |
| 80% | 80,0% | 51,1% | 89,4% | 98,5% |
| 90% | 90,0% | 51,8% | 93,8% | 97,4% |
| 95% | 95,0% | 52,2% | 96,0% | 96,8% |
As duas últimas colunas estão em fração do eleitorado. A decisão de fato aconteceu com 96,7% do eleitorado apurado. Enquanto \(k\) estava atrás, a projeção dizia que ele não seria eleito; depois da virada, ela passou a acertar cada vez mais.
Onde entra a inferência baseada em modelos
A regra determinística usa o modelo mais fraco possível: ela só sabe que cada escore \(a_{ij}\) está entre \(-1\) e \(1\). O seu “intervalo de predição” para a margem da parte não observada é
\[[-M_r,\ M_r],\]
e a eleição é decidida quando esse intervalo inteiro está de um lado de \(-t_{ds}\).
A regra de Cantelli já dá um passo além: ela troca o intervalo de pior caso por duas hipóteses, sobre a média e o desvio-padrão de \(t_{dr}\), e aceita uma probabilidade pequena e controlada de erro. Um modelo estatístico completo, que liga o resultado de cada seção ao resultado dela na eleição anterior, vai mais longe: ele dá um intervalo preditivo ainda mais estreito para \(t_{dr}\), e a eleição pode ser decidida mais cedo ainda. É isso que quem faz projeções na noite da eleição faz há décadas. A parte difícil é que os primeiros resultados não são uma amostra aleatória: algumas regiões sistematicamente chegam antes das outras. Mas isso fica para um próximo post.
Provavelmente porque eu gosto bastante de amostragem.↩︎
Dá para ler todas essas regras como uma relação sinal-ruído. O sinal é a margem que esperamos ao final, \(S = t_{ds} + \mu_r\), e o ruído é a incerteza sobre o que falta apurar, \(\sigma_r\). Com \(\rho = S / \sigma_r\), a desigualdade de Cantelli diz que \(\Pr(\text{virada}) \le 1/(1 + \rho^2)\), e a regra é simplesmente anunciar quando \(\rho \ge z_\alpha\). Com \(\lambda = 0\), essa razão é \(\rho = \frac{f}{1 - f} \times \frac{\hat v (2 \hat p_k - 1)}{\tau}\): a chance de apuração, \(f/(1-f)\), vezes a margem por eleitor medida em unidades de ruído. ↩︎